门诊里新诊断的 2 型糖尿病,用药时机的差别能拉得很开。有人确诊当天就上了药,三个月复查糖化血红蛋白已经降下来;也有人怕低血糖,拖到半年后才肯吃第一片。我把这批随访数据拉出来,想比较早用药的是不是感染更少。
初版结果挺漂亮,早用药组五年感染风险低了一截。可往下翻基线表,我心里一沉:早用药那批人更年轻、肾功能更好、合并症更少,本来就是不容易感染的一批。更要命的是另一个细节,我把每个人的随访起点定在确诊日,而真正吃上第一片药,中间隔着几周甚至几个月。这段还没用药的时间,被我算进了用药组。
真正要回答的是哪个问题。是「确诊后早吃药的人后来怎么样」,还是「让一批条件相当的人从确诊起就走早用药这条路,结局会不会不同」。前者是描述,后者才是临床想问的因果。
临床问题:早用看着好 → 研究问题:起点定在哪
把后一个问题写成一份随机试验的格式,再用观察数据去模拟它,这套方法叫目标试验模拟(target trial emulation,TTE)。方案里有七个要素要交代清楚:资格标准、治疗策略、分配方式、随访起点、结局、因果对比、分析计划。
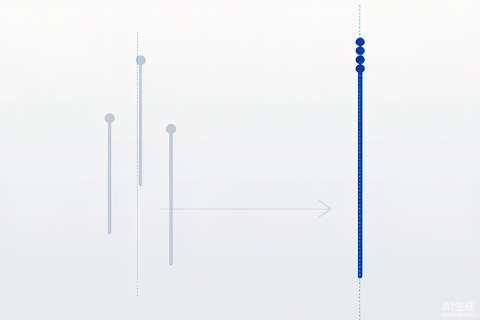
最容易写错的是随访起点,方法学上叫时间零点(time zero)。它的定义很硬:资格评估、治疗分配、随访开始,三件事必须落在同一天。随机试验里这一刻就是随机化当天,抽签结果尚未揭晓,两组起点天然对齐。
观察数据里没有抽签,三件事常常错位。随访从入组日算起,用药从首剂日算起,中间隔着一段。而这段被算进用药组的时间里,病人必须还没发生结局、还得活着,才可能被归进用药组。换句话说,用药组在这段时间里「不可死」。这种由入选方式本身制造出来、结局不可能发生的时间,就是不朽时间偏倚(immortal time bias)。它通常把差异推向有利于早用药的方向,让那一组看起来活得更久。
Hernán 与 Robins 在 American Journal of Epidemiology(2016;183:758-764)把这套框架立了起来,明确要求先写方案再动数据。他们 2026 年发表在 Epidemiology(2026;37:282-286)的新作进一步讨论了一件事:目标试验的方案从哪里来。结论很朴素,方案是从临床问题里定的,不是从数据里凑出来的。
临床问题:有人三个月后才用药 → 研究问题:怎么公平地比
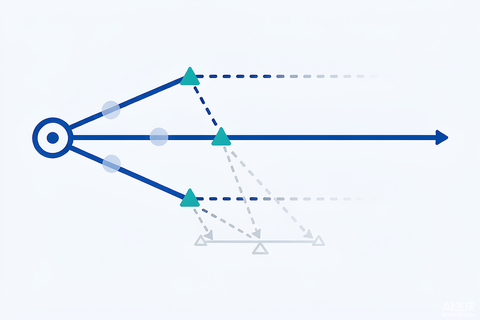
如果策略本身就带一段宽限期,比如「确诊后三个月内启动」,时间零点当天你并不知道这个人会走向哪一组。硬分组,等于又回到老路上。
现在通行的解法叫克隆-删失-加权(clone-censor-weight)。在时间零点把每个人复制进所有策略,让他同时参加几个平行试验;此后一旦他的实际用药与某个克隆被分配的策略不符,就把那个克隆删失;最后用删失权重重算,把被删失的人按概率还原回人群。这样每个策略组在起点上是同一批人,估计的是「始终遵守某个策略」的效应,即 per-protocol 效应(遵循方案效应)。
这么做的代价是精度。Nicolaisen、Thomsen 与 Pedersen 在 Clinical Epidemiology(2026;18:1-13,DOI 10.2147/CLEP.S618946)发表的方法学评估,用丹麦某注册研究团队的队列做实例:33,857 名新诊断糖尿病患者,统一以诊断日为索引日,克隆进四种启动时机的策略,分别是诊断后 15 天内、15 天至 3 个月、3 至 6 个月、6 至 12 个月,比较五年感染风险。加权后四个数字依次是 67.0%(95% CI 65.3 至 68.5)、65.7%(64.1 至 66.9)、66.8%(61.8 至 71.9)、67.8%(62.8 至 72.7)。
四个点估计全落在 2.1 个百分点宽的区间里,谁先谁后差别不大。可精度差得远:最早启动组的置信区间跨 3.2 个百分点,最晚一组跨 9.9 个百分点,约前三倍。策略越靠后,能保留的未删失克隆越少,结果越依赖权重,估计就越飘。这篇评估给出的提醒是,读这类文章别只看点估计,先看它跨了多宽。
方法用对了,也未必给出顺耳的结论。一项脓毒性休克的模拟(MIMIC-IV 数据库 5,461 例,J Intensive Care Med 2026,DOI 10.1177/08850666261479700)按基线升压药当量剂量分层后,较高剂量层里早期启动与最初 48 小时风险升高相关(HR 2.87,95% CI 1.68 至 4.90),作者自己提示这更像休克严重度的残余混杂,而不是早期用药本身的伤害。
临床问题:模拟结果能信几分 → 研究问题:账本在哪
模拟得像不像,是有账可查的。BMJ 2026 年 5 月发表的那篇系统综述与 meta 分析《Concordance between target trial emulation and randomised controlled trials》(BMJ 2026;393:e086810)把已发表的模拟逐篇配对到它所模仿的随机试验,共 49 项研究、106 对。总体上效应量相关系数 0.58(95% CI 0.43 至 0.69),方向与幅度都一致的配对占 79%(84/106),合并比值比 0.97(95% CI 0.92 至 1.03)。不算差,也远谈不上好。
分组结果更值得看:模拟设计更贴近原试验的 62 对里,相关系数升到 0.83(0.73 至 0.89),一致率 87%(54/62)。差距不主要出在数据源,出在设计贴得够不够近。
账本上还剩两笔支出。一笔是透明度:只有 16 项(33%)按 TARGET 报告规范(Transparent Reporting of studies Emulating a Target Trial)撰写,做了方案注册的占 35%。另一笔在模拟质量:多变量模型里与一致性偏低稳定相关的三类特征,是基线人群特征不平衡、存在延迟治疗效应、结局模拟质量偏低。理赔类数据库还有一层硬伤,它常抓不到住院用药与确切的启动时间,模拟只能从出院时点开始观察,等于漏掉早期暴露,又把不朽时间带了回来。
临床问题:方法懂了还是跑不动 → 研究问题:哪些步骤能交出去
这套东西想明白不难,写清楚费劲。我现在把几件事交给 DeepBio,按「上传资料、结构化分析、复核迭代」这条路走。
第一,临床研究辅助。把研究背景、拟纳入人群、候选终点连同既往文献一起上传,让平台把目标试验方案的七要素整理成一张可核对的表,资格标准、治疗策略、分配方式、随访起点、结局、因果对比、分析计划各占一行,缺哪行一眼能看见。
第二,实验与研究设计。把时间零点的定义、克隆规则、删失规则、加权方案写成可执行清单,注明每个变量在原始数据里对应哪一列、缺失时怎么处理。清单落到这一层,做数据的人才清楚要跑什么。
第三,文献与证据整理。把方法学文献按适用条件排成对照表,标出主要风险点与后续验证路径,投稿前逐条自查,省得被问到为什么不用另一种起点。
第四,综述与论文写作。套用院校学位论文格式模板,统一全篇版式,引文与参考文献一次对齐。
边界还是要讲清:DeepBio 做的是研究辅助,不替代专业判断;文中涉及的健康与临床内容不构成医疗建议。
你手里那批数据,时间零点是怎么定的?是入组日、首剂日,还是某个检查完成日?欢迎在评论区留下你的具体设定,我挑几类常见的错位做一次拆解。
面向医学研究,从方案设计到论文成稿的一站式工作台
标签:#SCI #真实世界研究 #论文写作 #循证医学 #科研方法 #临床研究 #DeepBio