假设你面前躺着两款 AI 问诊系统,宣传页上都写着「诊断准确率 90%」。一款在 5000 例三甲医院门诊数据上测出来的,一款在 8 万例基层患者真实问诊数据里跑出来的,你选哪个?
再告诉你一个细节:前者 5000 例里 4800 例都是同一个病种,后者 8 万例覆盖 40 个病种。准确率还是同一个「90%」,含义已经完全不同了。
这不是我编的假设。8 月底,首届全国数智健康大赛上,仁济医院的泌尿 AI 智能体拿了奖。公开信息里能看到两个数字:服务总量超过 80 万人次,咨询里有 65% 来自三线及以下城市。数字医疗正在往基层跑,而基层人群的疾病谱、就诊习惯和既往病史记录,跟三甲医院门诊完全是两个样本空间。这个「80 万」和「65%」背后,其实是一道统计题。
今天我不聊哪个大模型参数多,就从一个数据分析师的角度,带你拆一拆医疗 AI 那些刷屏数字,到底该怎么读。
陷阱一:准确率是个「会撒谎的平均数」
医学 AI 报道里最常见的数字是「准确率 95%」「诊断符合率 94.3%」。准确率本身没错,错的是它把敏感度和特异度揉成了一个数,而这两个指标在不同人群里的含义差别巨大。
打个比方:一款肺癌筛查 AI,敏感度 99%、特异度 99%,听起来完美。但放到一个患病率只有 1% 的体检人群里,算一下阳性预测值,每 100 个被 AI 标成「阳性」的人里,大约有一半其实是健康的。准确率还是那个准确率,但它在基层筛查场景和专科门诊场景里的临床价值完全两样。
读数字的第一步:先问敏感度、特异度各是多少,阳性预测值在目标人群里是多少。只报一个准确率,等于只给你看平均分,不给你看单科成绩。
陷阱二:考试高分不等于临床能用
华佗 GPT 是个被反复讨论的案例。公开资料显示,这个由深圳市大数据研究院与香港中文大学(深圳)联合研发的模型,2023 年就通过了国家执业药师资格考试,成为国内公开的首个通过多个医疗资格考试的大模型。听起来很厉害,但它的落地路径值得琢磨:不是直接进诊室替代医生,而是从龙岗区公立医院的智能导诊、预问诊这类低风险辅助场景切入,一步步试出来的。
这里藏着一个关键区别:考试是封闭环境,题目和答案范围已知;真实临床是开放环境,患者主诉可能模糊、病历可能缺项、指南可能冲突。一个在测试集上拿高分的模型,换到真实世界可能就是另一回事。
所以看到「XX 基准测试第一」「考试 90+ 分」这类数字时,别急着转发,先看它的验证环境离真实临床有多远。今年 5 月底发布的《2026 医疗智能体应用发展白皮书》也反复强调同一件事:医疗智能体要真正进临床,光有模型能力不够,还得具备知识约束、结果溯源这类能力。能不能说出依据、敢不敢说不知道、要不要人来把关,比单纯刷分重要得多。
陷阱三:指标好看,不等于医生愿意用
最后一个陷阱更隐蔽。很多医疗 AI 论文报的是「模型单独跑出来的准确率」,但临床上真正决定价值的是人机协同后的结果,也就是医生用了 AI 之后,诊断准确率到底提升了没有。
仁济那个泌尿智能体的做法就值得学习:它做了真实世界临床对照,分别比较 AI 辅助下的实习医生、社区医生、专科医生和不用 AI 时的诊断表现,结论是各层级医生都被「托了一把」。这种设计才是医疗 AI 评估该有的样子:不是让 AI 单独考试,而是看 AI 进到工作流之后,人的表现有没有变好。
下次再看到医疗 AI 的新闻,先找三个信息:有没有外部验证集、有没有真实世界对照、报告的是模型指标还是人机协同指标。三个都没有的,基本可以当宣传稿看。
学会拆数字,从拆一篇 AI 医疗论文开始
说了这么多,具体怎么练?我自己是用 DeepBio 拆的,三步走。
第一步,先做一份验证信息核对表。 找一篇医疗 AI 评估类论文,PDF 传上去选「文献与证据整理」,让它把验证设计拆出来:训练集和验证集各来自哪里、样本量多少、纳排标准是什么、报告了哪些指标、有没有外部验证。你要的敏感度、特异度、阳性预测值这些数字,一张卡片列全,出处还在。
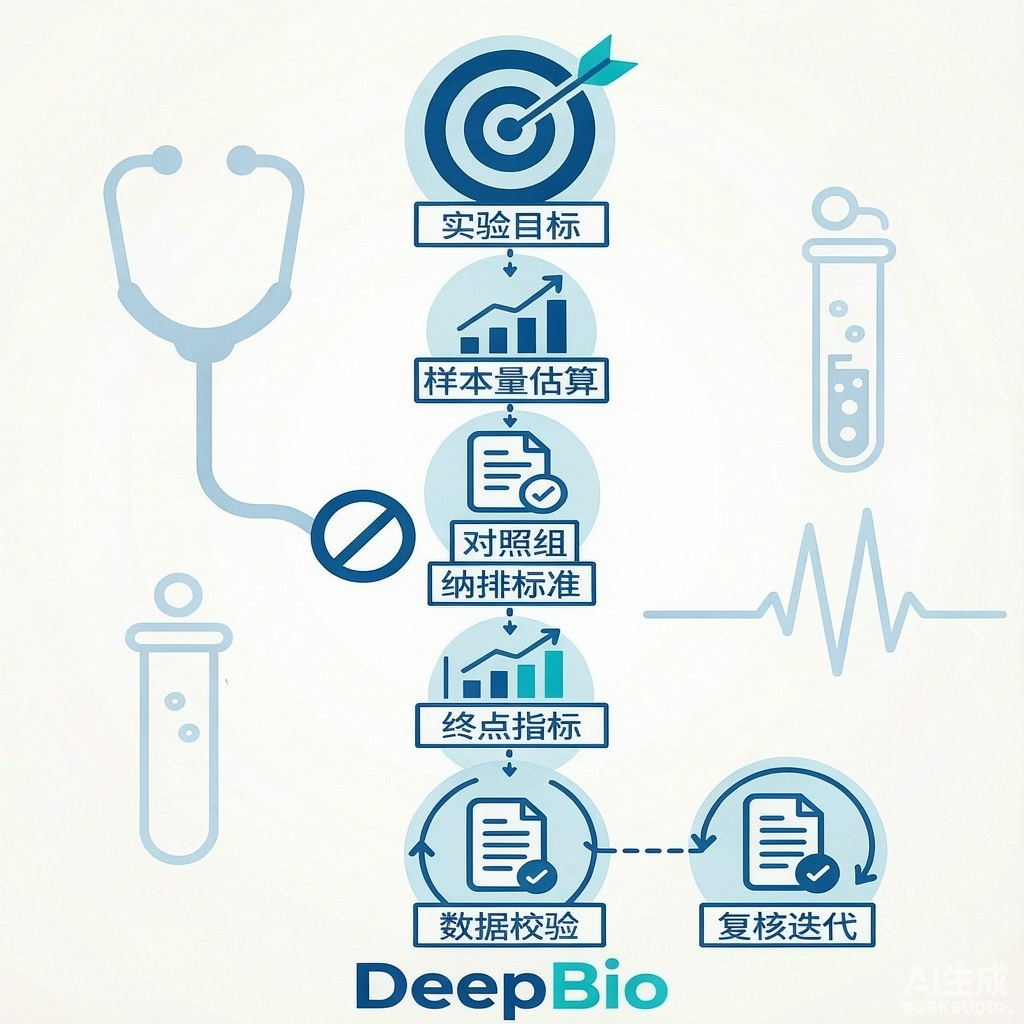
第二步,把研究问题交给实验设计。 导师让你做「某 AI 辅助诊断系统的临床评估」,别从零想方案。选「实验与研究设计」,把研究问题贴进去,它会帮你梳理实验目标、样本需求、关键变量:样本量怎么估、纳排标准怎么写、对照组怎么设、终点指标选什么。这些正是踩坑高发区,先把框架立住,再往细节里钻。
第三步,把方案整理成能对齐的研究计划。 选「临床研究辅助」,把试验方案、纳排标准、终点设计和监查要点结构化整理出来,方便跟导师逐条对齐。数字医疗的评估研究,说到底也是一项临床试验,流程规范了,结果才经得起推敲。
医疗 AI 的浪潮里,会写代码的人很多,会读数字的人很少。而读数字这门手艺,恰恰是统计思维给的。下次再看到「准确率 90%」刷屏,不妨先问一句:这个 90%,是在哪群人身上测出来的?
你最近看到哪个医疗 AI 的数字特别想验证?评论区告诉我,我帮你拆一拆它的验证设计。
标签:医疗智能体 · 数字医疗 · 统计思维 · 文献阅读 · 临床研究 · 辅助诊断 · 证据等级 · 医学生 · 科研工具 · DeepBio